ドキュメント · ルーティンググループ
インテントルーティング
ユーザーが何を求めているかで、ターンを送るモデルを決めます。テストは強いモデルへ、ちょっとした質問は速くて安いモデルへ。それぞれの種類を数語で書いておけば、ターンの始まりに、あなたが選んだ小さなモデルがメッセージの種類を判定します。
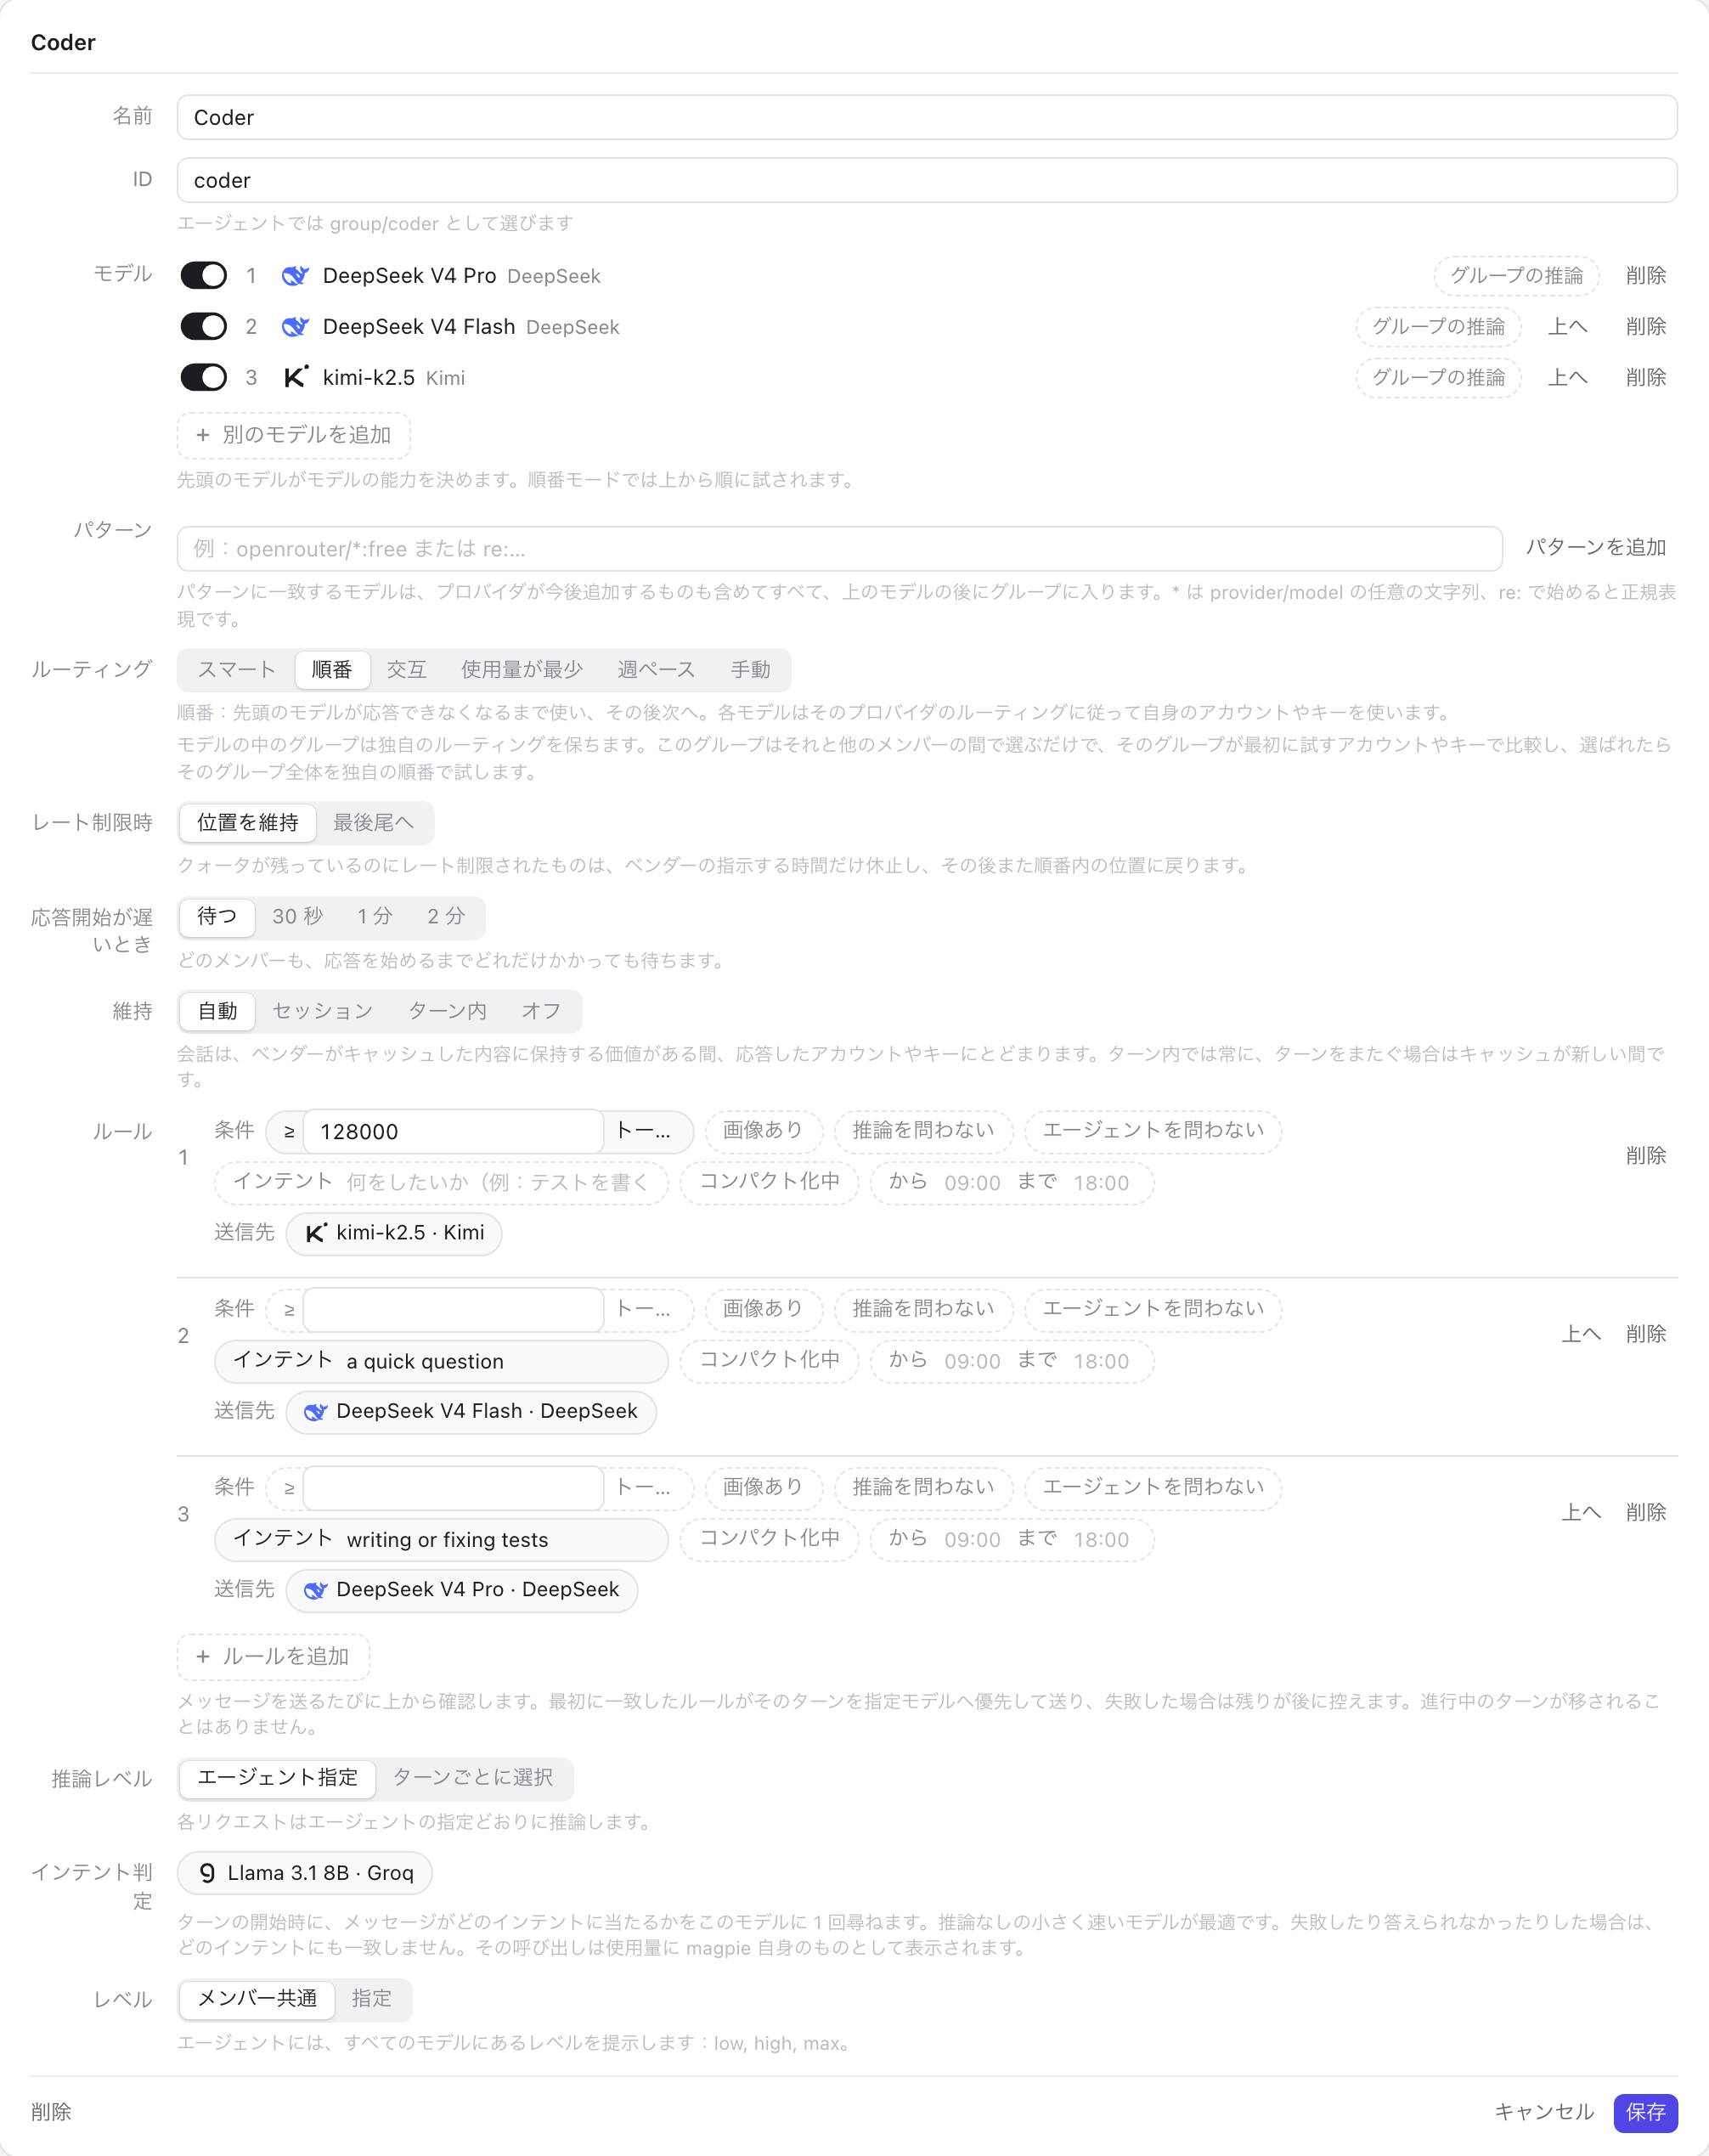
インテントはルーティンググループのルールに付けられる条件の一つで、長さ・画像・推理・エージェントと並びます。このページでは、v0.1.99 時点で magpie がインテントをどう扱うかを正確に説明します。すべての判断を予測でき、ルーティングタブで確かめられるようにするためです。
設定する
モデルが 2 つ以上あるルーティンググループと、判定用のモデルがもう 1 つ必要です。判定モデルは magpie にあるモデルならどれでもよく、グループに入っているかどうかは問いません。
- グループを開くRouting を開き、Routing groups からグループを探して Edit をクリックします。
- インテント付きのルールを追加するAdd a rule をクリックし、send to でモデルを選び、asks for をクリックして、メッセージが求めていることを書きます(例:writing or fixing tests)。同じルールのほかの条件も満たされている必要があります。
- 判定モデルを選ぶルールにインテントが付くと Intent told by が表示されます。推理なしの、小さく速いモデルを選んでください。インテントがあって判定モデルがないグループは保存できません。
- 保存して、メッセージを送る変更は次のターンから反映され、再起動は不要です。Routing タブに、判定モデルの答えとターンの行き先が表示されます。
ターミナルからも同じことができます。
magpie group rule add coder use=deepseek/deepseek-v4-flash intent="a quick question" classifier=groq/llama-3.1-8b-instant
magpie group rule add coder use=deepseek/deepseek-v4-pro intent="writing or fixing tests"
magpie group rule coder                           # the rules, numbered, and the classifier
magpie group rule classifier coder groq/llama-3.1-8b-instant   # change the classifier
magpie group rule mv coder 3 1                    # order matters: top first
magpie group rule rm coder 2
intent= は asks= と about= とも書けます。classifier= は classify= と by= とも書けます。rule add の classifier= はグループの判定モデルを設定するもので、最初の 1 回だけ必要です。判定モデルは ~/.config/magpie/providers.json のグループのレコードに "classifier" として、各ルールは {"use": …, "intent": …} として保存されます。
ターンのルーティング
ルールのあるグループにエージェントが送るリクエストは、すべて次の手順をこの順に通ります。
- 新しいターンか?magpie はリクエストの最後のユーザーメッセージを見ます。テキストか画像があり、ツール結果がなければ、あなたが発言したばかりなので新しいターンが始まります。ツール結果があれば、エージェントが進行中のターンを続けています(ターンの残りを参照)。ターンは会話ごとに数えます。サブエージェントは独立した会話です。エージェントとセッションを共有しますが、最初の言葉が異なります。
- どのインテントが決め手になりうるか?magpie はインテントをいったん無視して、ルールを上から順にたどります。インテント以外の条件(トークン数・画像・推理・エージェント)がこのリクエストで満たされるルールが候補です。各候補のインテントを集め、大文字小文字の違いだけの重複は 1 つとして数えます。インテントのない候補に当たった時点でたどるのをやめます。そのルールは無条件で一致し、それより下のルールが先に来ることはないからです。インテントが 1 つも集まらなければ、判定モデルには問い合わせず、費用もかかりません。
- 判定モデルに問い合わせる集めたインテントとあなたのメッセージのテキストを判定モデルに送ります。正確なプロンプトは後述します。この呼び出しはエージェントからのリクエストと同じく magpie のゲートウェイを通るので、そのモデルのプロバイダのキーやアカウント、そのフェイルオーバーが使われます。回答の制限時間は 8 秒です。
- 答えを読むmagpie は返答の中で最初に出てくる整数を取ります。
1からnはそのインテントを、0はどれでもないことを表します。数字がない、範囲外など、それ以外はすべて失敗として扱います。答えは同じメッセージとインテントに対して 10 分間保持されます。 - ルールを照合するその答えでルールを上から順に照合します。インテント付きのルールは、判定モデルがそのインテントを(大文字小文字を区別せず)挙げ、かつほかの条件もすべて満たすときだけ一致します。最初に一致したルールが採用されます。どれも一致しなければ、グループはいつもどおりにターンをルーティングします。
- モデルを並べる採用されたルールのモデルが先頭になり、グループのほかのモデルはいつもの順でフェイルオーバーとして続きます。会話の前のターンに別のモデルが答えていても同じです。ターンの始まりでは、ルールが Stays 設定より優先されます。ルールのモデルにいま使えるものがない場合(キーがすべて休止中、プロバイダがオフなど)は、グループのいつもの順のままとなり、トレースにそう記録されます。
- 判断を記憶するmagpie はこの会話(グループ、エージェントのセッション、会話の最初の言葉)についての判断を判定モデルの答えとともに保持し、ターンの残りはそれに従います。
例
上の Coder グループには 3 つのルールがあります。
| # | 条件 | 送り先 |
|---|---|---|
| 1 | ≥ 128000 tokens | kimi/kimi-k2.5 |
| 2 | asks for “a quick question” | deepseek/deepseek-v4-flash |
| 3 | asks for “writing or fixing tests” | deepseek/deepseek-v4-pro |
- 2 万トークンのターン:ルール 1 は満たされないので、両方のインテントが候補になります。判定モデルは “a quick question” と “writing or fixing tests” のどちらかを選びます。
- 15 万トークンのターン:ルール 1 はインテントがなく満たされるので、そこでたどるのをやめます。判定モデルには問い合わせず、ターンは Kimi に送られます。
- 判定モデルが
0(どれでもない)と答えた場合:どのルールも一致せず、グループのルーティング(ここでは In order なので deepseek-v4-pro が先頭)に従います。
アプリでの様子
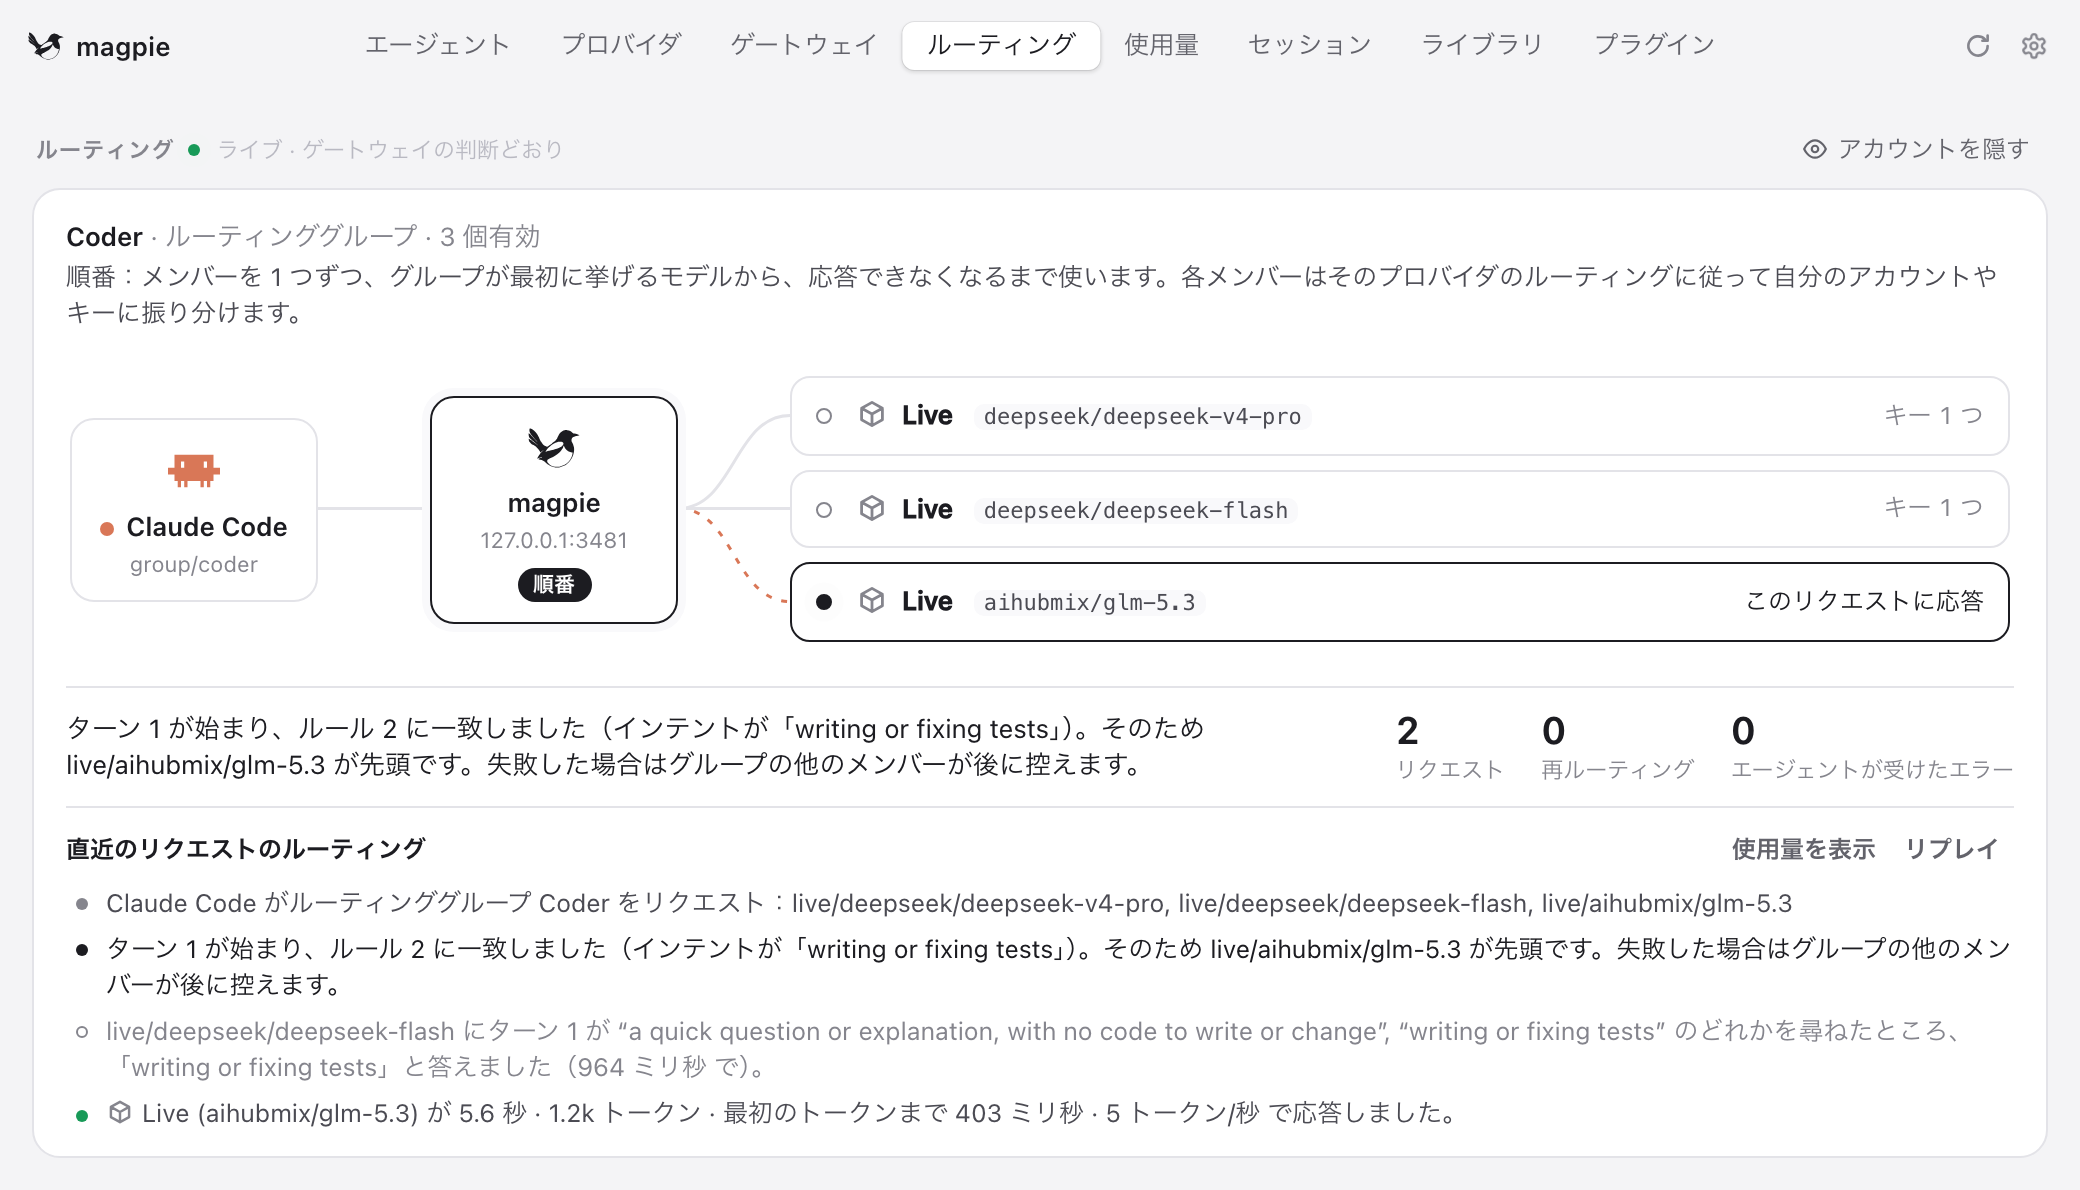
インテント付きのルールが 2 つ(“a quick question or explanation, with no code to write or change” と “writing or fixing tests”)あるグループに、Claude Code から実際のリクエストを送った例です。内容は「Add unit tests for the LRU cache in cache.go, covering eviction and concurrent reads and writes」。Routing タブにリアルタイムで表示されます。
判定モデルに送られる内容
リクエストの全文は以下のとおりで、ほかには何も送りません。システムメッセージは固定です。ユーザーメッセージには、手順 2 で集めたインテントがルールの順に並びます。
You route a user's message to a coding assistant by what it asks for. Given numbered kinds of request and the user's message, answer with the number of the kind the message is, or 0 if it is none of them. Answer with the number only.
Kinds:
1. a quick question
2. writing or fixing tests

The user's message:
<message>
Write unit tests for the parseTokens function and fix any that fail.
</message>

The number of its kind (0 for none):
- 最新のメッセージだけ。magpie が送るのは最後のユーザーメッセージのテキスト部分だけです。それより前のターン、システムプロンプト、ツール定義、ファイルは送りません。
- 画像は送りません。画像だけのメッセージには判定する言葉がないので、どのインテントも一致しません。画像でルーティングしたいときは、ルールの has an image 条件を使ってください。
- エージェントのリマインダーは取り除きます。Claude Code がメッセージに付け加える
<system-reminder>…</system-reminder>ブロックは削除します。エージェントが同じメッセージに入れたそれ以外のテキストは残ります。 - 長いメッセージは短縮します。4,000 文字を超える場合、最初の 3,000 文字と最後の 1,000 文字を
…でつないで送ります。何を求めているかは、たいてい最初と最後に書かれているからです。 - リクエストの設定。OpenAI 形式の chat completion で、ストリーミングなし、
temperature 0、max_tokens 2048、User-Agent はmagpie-router/1です。判定モデルの推理レベルがわかっていれば、最も低いものを指定します。noneがあればそれを、なければ最低のレベル(例:low)です。レベルが不明なら何も送らず、ベンダーのデフォルトに任せます。ほかのリクエストと同じく判定モデルのプロバイダ向けに変換するので、Anthropic や Gemini などのモデルも使えます。
判定できないとき
判定モデルは補助役であって、関門ではありません。判定モデルに何が起きても、ターンには必ず回答があります。インテント付きのルールが一致しなくなるだけです。
| 起きたこと | magpie の動き |
|---|---|
0 と答えた | どのインテントも一致しません。インテントのないルールとグループのいつもの順で決まります。 |
| 8 秒以内に答えがない | 失敗として扱います。どのインテントも一致せず、ターンはすぐに進みます。 |
| エラー(クォータ、5xx、無効なキー) | まず 8 秒の範囲内で、そのプロバイダ自身のフェイルオーバーを試します。それでも失敗すれば、どのインテントも一致しません。 |
| 0 から n の番号ではない答え | このターンではどのインテントも一致しません。判定モデルは答えてはいるので休止させず、次のターンでまた問い合わせます。 |
| エラーまたは 8 秒のタイムアウト | その判定モデルは 30 秒間使いません。その間のターンは判定モデルを待たず、トレースには問い合わせなかったと記録されます。正しい答えが 1 回返れば解除されます。 |
| メッセージに言葉がない | 問い合わせません。どのインテントも一致しません。 |
どの場合も、理由とともにターンのトレースに記録されます。つまりインテントルールのせいで、ターンが期待と違うモデルに送られることはあっても、ターンが失敗することはありません。
ターンの残り
1 つのターンは、数十のリクエストになることがよくあります。エージェントがツールを呼び、結果を送り返し、また別のツールを呼ぶ、という具合です。magpie はそれらを次のように扱います。
- 固定。ターン内のリクエストはすべて、ターンが始まったときのモデルに送られ、判定モデルには再度問い合わせません。ターンの途中でモデルを切り替えると、ベンダーが会話をキャッシュした分(プロンプトキャッシュ)が無駄になりますし、ほかのベンダーが書いた推理を受け付けないベンダーもあります。
- フェイルオーバー先に留まる。ルールのモデルが失敗して別のメンバーが答えた場合、そのメンバーがターンの残りを受け持ちます(Stays が Auto、Session、Within a turn のとき)。ルールは次のメッセージで改めて判断します。
- 容量超え。唯一の例外です。ターン内で会話が現在のモデルのコンテキストの 95% まで大きくなると、magpie は判定モデルの以前の答えを使ってルールをもう一度照合します。ルールがコンテキストのより大きいモデルを指せば、そちらに移ります。より小さいモデルに移ることはありません。
- 待機。magpie がターンの始まりを見ていない場合(ターンの途中で起動・再起動した)や、判断したルールが削除されたり別のモデルを指すようになったりした場合、ルールはそのターンを動かしません。次のメッセージでルールが改めて判断します。
- サブエージェント。サブエージェントのターンは、サブエージェント自身のメッセージから独立して判断します。エージェントはそのままで、サブエージェントだけをルールで別のモデルに送ることもできます。
判断は、会話の最後のリクエストから 24 時間メモリに保持されます。magpie を再起動すると消え、次のメッセージで改めて判断します。
トレースの読み方
Routing タブには、各グループの最新のリクエストについて、どのモデルが答えたか、そして How the last request was routed の下にその理由が表示されます。
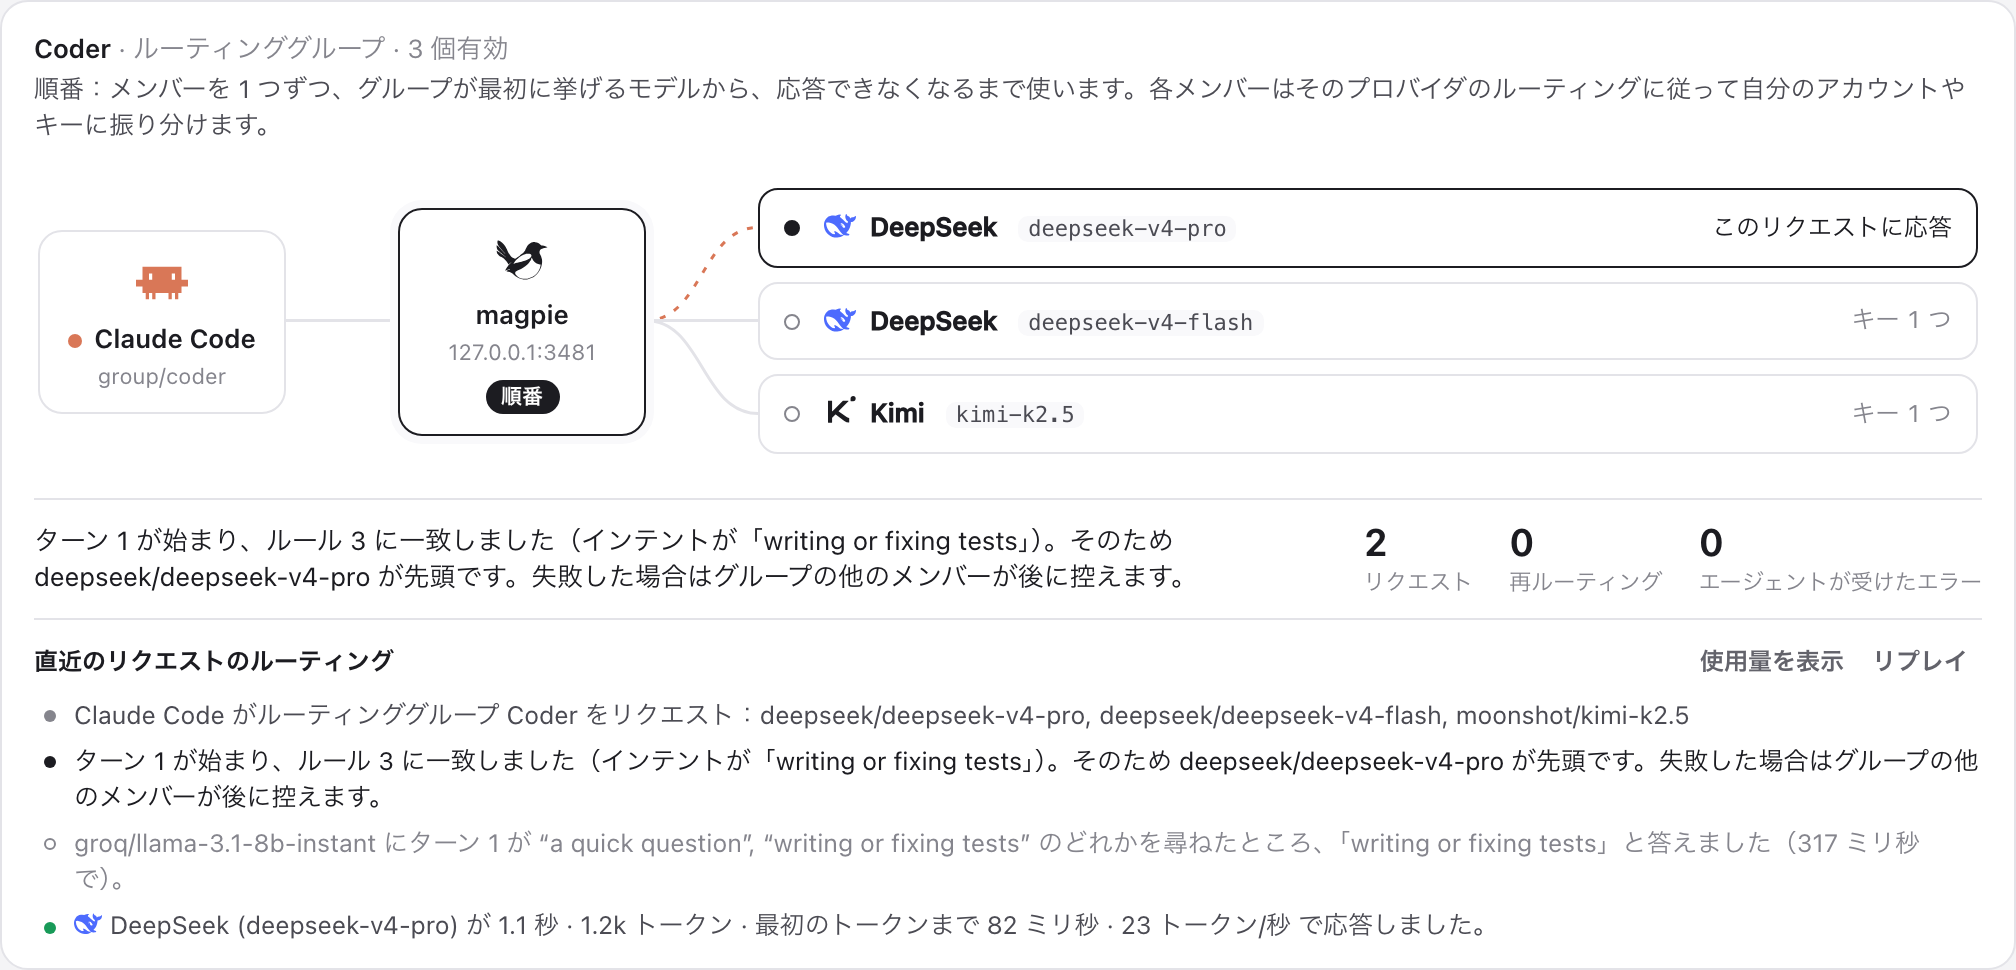
インテントに関してトレースに出る行は次のとおりです。
| トレースの表示 | 意味 |
|---|---|
| … was asked which of “A”, “B” turn 1 is, and said “B” (in 323 ms). | 判定モデルにこれらの候補で問い合わせ、B が選ばれました。 |
| … and said none (…). | 0 と答えました。 |
| … (said before, for the same message). | 答えは 10 分間のキャッシュから取ったもので、呼び出しはしていません。 |
| … was to tell which … but couldn’t — reason — so no rule with an intent matches it. | 失敗しました。理由はエラー、タイムアウト、返ってきた答え、または失敗後の休止中であることです。 |
| Turn N begins and rule R matches — asks for “B” — so M goes first … | 採用されたルールと、先頭になったモデルです。 |
| Rule R matches, but M has no account or key that can take this request, so the group’s order stands. | ルールのモデルには、このリクエストを処理できるアカウントやキーがありません。 |
| Rule R (…) sent turn N to M as it began; the turn stays there. | ターン内のツールのやり取りで、ターン開始時の判断に従っています。 |
| This turn began before magpie saw it, so the rules wait for the next one. | 上の待機を参照してください。 |
判定モデル自身の呼び出しは Usage にエージェント magpie として、トークン数と費用付きで記録されるので、判定にかかる費用を確認できます。
レイテンシ・費用・プライバシー
- レイテンシ。判定モデルを待つのはターンの最初のリクエストだけで、速いプロバイダなら通常数百ミリ秒(スクリーンショットでは 323 ms)、長くても 8 秒です。ターン内のツールのやり取り、インテントが決め手にならないターン、キャッシュされた答えでは、待ち時間は増えません。
- 費用。ターンごとに短い呼び出しが 1 回です。入力はメッセージとインテントを合わせた程度、出力は 1〜2 トークンです。上の例では入力 212 トークン、出力 1 トークンでした。サブスクリプションのモデルを判定モデルにすると、これらの呼び出しはそのサブスクリプションの上限に数えられます。
- プライバシー。メッセージのテキスト(最大約 4,000 文字)は判定モデルのプロバイダに送られます。手元のマシンから出したくなければ、Ollama や LM Studio のローカルモデルを判定モデルにしてください。magpie が保持するのはメッセージのハッシュと答えだけで、メモリ上に 10 分間です。メッセージそのものは保存もログ記録もしません。
よいインテントの書き方
- モデルではなく、リクエストを書く。「hard tasks for Opus」ではなく「writing or fixing tests」と書きます。判定モデルが見るのは、あなたの言葉とメッセージだけです。
- 種類どうしを重ねない。2 つのインテントが重なっている(「a question」と「a question about the code」など)と、小さなモデルはどちらを選ぶか予測できません。まとめるか、違いをはっきりさせてください。
- 細かく多くより、少なく大まかに。インテントが 2〜5 個なら 8B モデルでも簡単に判定できます。1 つあたり 200 文字まで書けますが、たいていは数語で足ります。
- 順番は今も重要。数えられるのは最初に一致したルールだけなので、必ず勝たせたいルール(長いコンテキスト用のルールなど)はインテントルールより上に置きます。そうすれば、そのルールが満たされるときは判定モデルを飛ばします。
- 「どれでもない」も立派な答え。どのインテントにも当てはまらないターンはグループのいつもの順に送られるので、その順をデフォルトの選択にしておきましょう。
- 言語は問いません。インテントもメッセージも、判定モデルが理解できる言語なら何語でもかまいません。固定のプロンプトは英語ですが、小さなモデルでも複数言語の混在はよく読めます。
- 判定モデルの選び方。推理なしの、小さく速いモデルを選びます。Groq の Llama 3.1 8B、Flash-Lite・nano・mini 系のモデル、Claude Haiku、DeepSeek の推理なしチャットモデル、ローカルモデルなどです。推理モデルは遅くなります。magpie は最も低い推理レベルを指定し 2048 トークンの余裕を残しますが、遅いモデルだと 8 秒に間に合わないことがあります。何ターンかトレースを確認し、判定が外れるようなら、モデルを替える前にインテントを書き直してみてください。
数値一覧
| 項目 | 値 |
|---|---|
| 判定モデルのタイムアウト | 8 秒(プロバイダのフェイルオーバーを含む) |
| 失敗後の休止 | 30 秒、判定モデルごと |
| 答えのキャッシュ | 10 分、判定モデル+インテント+メッセージごと。メモリ上 |
| ターンの判断の保持 | 会話の最後のリクエストから 24 時間。メモリ上 |
| 送るメッセージ | 最大 4,000 文字。超える場合は最初の 3,000+最後の 1,000 |
| 判定リクエスト | temperature 0、max_tokens 2048、モデルの最も低い推理レベル、ストリーミングなし |
| インテントの長さ | 最大 200 文字。空白はまとめ、大文字小文字を区別せずに比較 |
| 容量超え | 現在のモデルのコンテキストの 95% で発動。より大きいモデルにのみ移る |
FAQ
埋め込みやベクトル検索ですか?
いいえ。埋め込みモデルも、類似度のしきい値も、キーワードリストも、学習するものもありません。判定モデルは普通のチャットモデルで、インテントとメッセージを読んで番号で答えます。精度はそのモデルとあなたの書き方次第で、すべての答えはトレースで確認できます。
会話全体を見ますか?
いいえ、いま送ったメッセージだけです。そのため「now do the same for the other file」のような続きの指示は、その言葉だけで判定されます。そのターンのメッセージをもっと明確にするか、続きの指示に合うインテントを追加してください。
1 つのメッセージでエージェントが 40 回リクエストしました。判定モデルに 40 回問い合わせたのですか?
いいえ、1 回です。残りの 39 回はツール結果を含んでいたので同じターンに属し、そのターンの判断に従います。トレース(“the turn stays there”)と Usage(magpie の呼び出しが 1 回)で確認できます。
ターンの途中でモデルが切り替わることはありますか?
2 つの場合だけです。いまのモデルが失敗して別のメンバーが引き継いだときと、会話がモデルのコンテキストを超えそうになり、ルールがより大きいモデルに送ったときです。ターンの途中でインテントを問い合わせ直すことはありません。
判定モデルが落ちている、または遅いときは?
ターンはそのまま進みます。最大 8 秒後、どのインテントも一致せず、グループのほかのルールと順番で決まります。その後 30 秒間はその判定モデルに問い合わせないので、ターンごとにタイムアウトを待つことはありません。理由はトレースに出ます。
判定モデルがインテントを挙げたのに、ルールのモデルに送られなかったのはなぜ?
トレースを確認してください。よくある原因は次のとおりです。
- それより上のルールが先に一致した。
- ルールのほかの条件(トークン数・画像・推理・エージェント)が満たされなかった。
- ルールのモデルに、このリクエストを処理できるアカウントやキーがなかった。
- 別のモデルで始まったターン内のツールのやり取りだった。
- magpie がターンの始まりを見ていなかった(“the rules wait”)。
2 つのルールが同じインテントを持っていたら?
そのインテントは判定モデルに 1 回だけ提示されます。選ばれた場合、それらのルールのうち、ほかの条件を満たす最初のものが採用されます。たとえば “writing or fixing tests” を、Codex からならあるモデルへ、Claude Code からなら別のモデルへ送る、といった使い方ができます。
ルールを変えると、実行中のターンに影響しますか?
いいえ。保存した内容は次のターンから反映されます。ルールを削除したり別のモデルを指すようにしたりしても、そのターンはそれまでの場所に留まり、トレースには the rules wait と出ます。
判定モデルにルーティンググループや、グループ自身のモデルを使えますか?
グループは使えません。provider/model 形式の単一のモデルである必要があり、保存時に magpie がチェックします。モデルなら magpie にあるものは何でも使えます。グループのメンバー、サブスクリプションのモデル、ローカルモデルも含みます。
推理モデルは使えますか?
8 秒以内に答えるなら使えます。magpie は最も低い推理レベル(none、なければ最低のレベル)を指定し、2048 トークンの余裕を残すので、思考に押されて答えが出ないことはありません。それでも、小さく速いモデルのほうがよい選択です。安いですし、すべてのターンがそれを待つからです。
実際のモデルでどのくらいうまく動きますか?
インテントルールが 2 つあるグループに、実際のコーディング用メッセージを 20 件(英語と中国語。ちょっとした質問、テスト作業、「Fix the bug in parseTokens and add a test for it」を含む普通のコーディングタスク)送りました。DeepSeek V4 Flash、GLM-5.3 Flash、MiMo v2.6 Flash はいずれも 20 件すべてを正しく判定し、判定時間の中央値はそれぞれ 0.75 秒、1.3 秒、1.9 秒でした。ある再販業者経由の Gemini 3.8 Flash は low の推理でも 11 秒かかり、すべてのターンがタイムアウトして、インテントがないものとしてルーティングされました。トレースには毎回そのとおり記録されています。これが想定すべきパターンです。判定モデルがうまく動かなくても失うのはルーティングだけで、ターンは失いません。
同じメッセージを再送すると、また問い合わせますか?
10 分以内なら問い合わせません。同じメッセージ・同じインテント・同じ判定モデルならキャッシュから答え、トレースには “said before” と出ます。インテントか判定モデルを変えると、改めて問い合わせます。
どのエージェントで使えますか?
magpie 経由でルーティンググループに送るエージェントなら、どれでも使えます。Claude Code、Codex、OpenCode、Gemini CLI などです。ターンはエージェントが使う API に関係なく、リクエストそのもの(テキストがあり、ツール結果がないメッセージ)から検出します。
メッセージはどこかに保存されますか?
magpie が保持するのは、メッセージのハッシュ(キャッシュ用)と判定モデルの答えだけで、メモリ上のみです。テキストはほかのリクエストと同じく判定モデルのプロバイダに送られ、そのプロバイダの規約に従います。判定モデルの使用記録にはトークン数が残り、テキストは残りません。
精度はどのくらいですか?
判定モデルと、インテントどうしがどれだけはっきり違うかによります。明確に異なる種類が少しだけなら、小さなモデルでもよく当てます。重なりがあると、ときどき当て推量になります。答えが外れたり出なかったりしても、どのモデルが答えるかが変わるだけなので、まずは大まかなインテントを 2〜3 個から始め、1 日トレースを見て言い回しを調整してください。