文档 · 路由组
意图路由
按用户想做什么来选模型:写测试交给强模型,随口一问交给又快又便宜的模型。你用几个词描述每一类请求,每一轮开始时,由你指定的一个小模型判断这条消息属于哪一类。
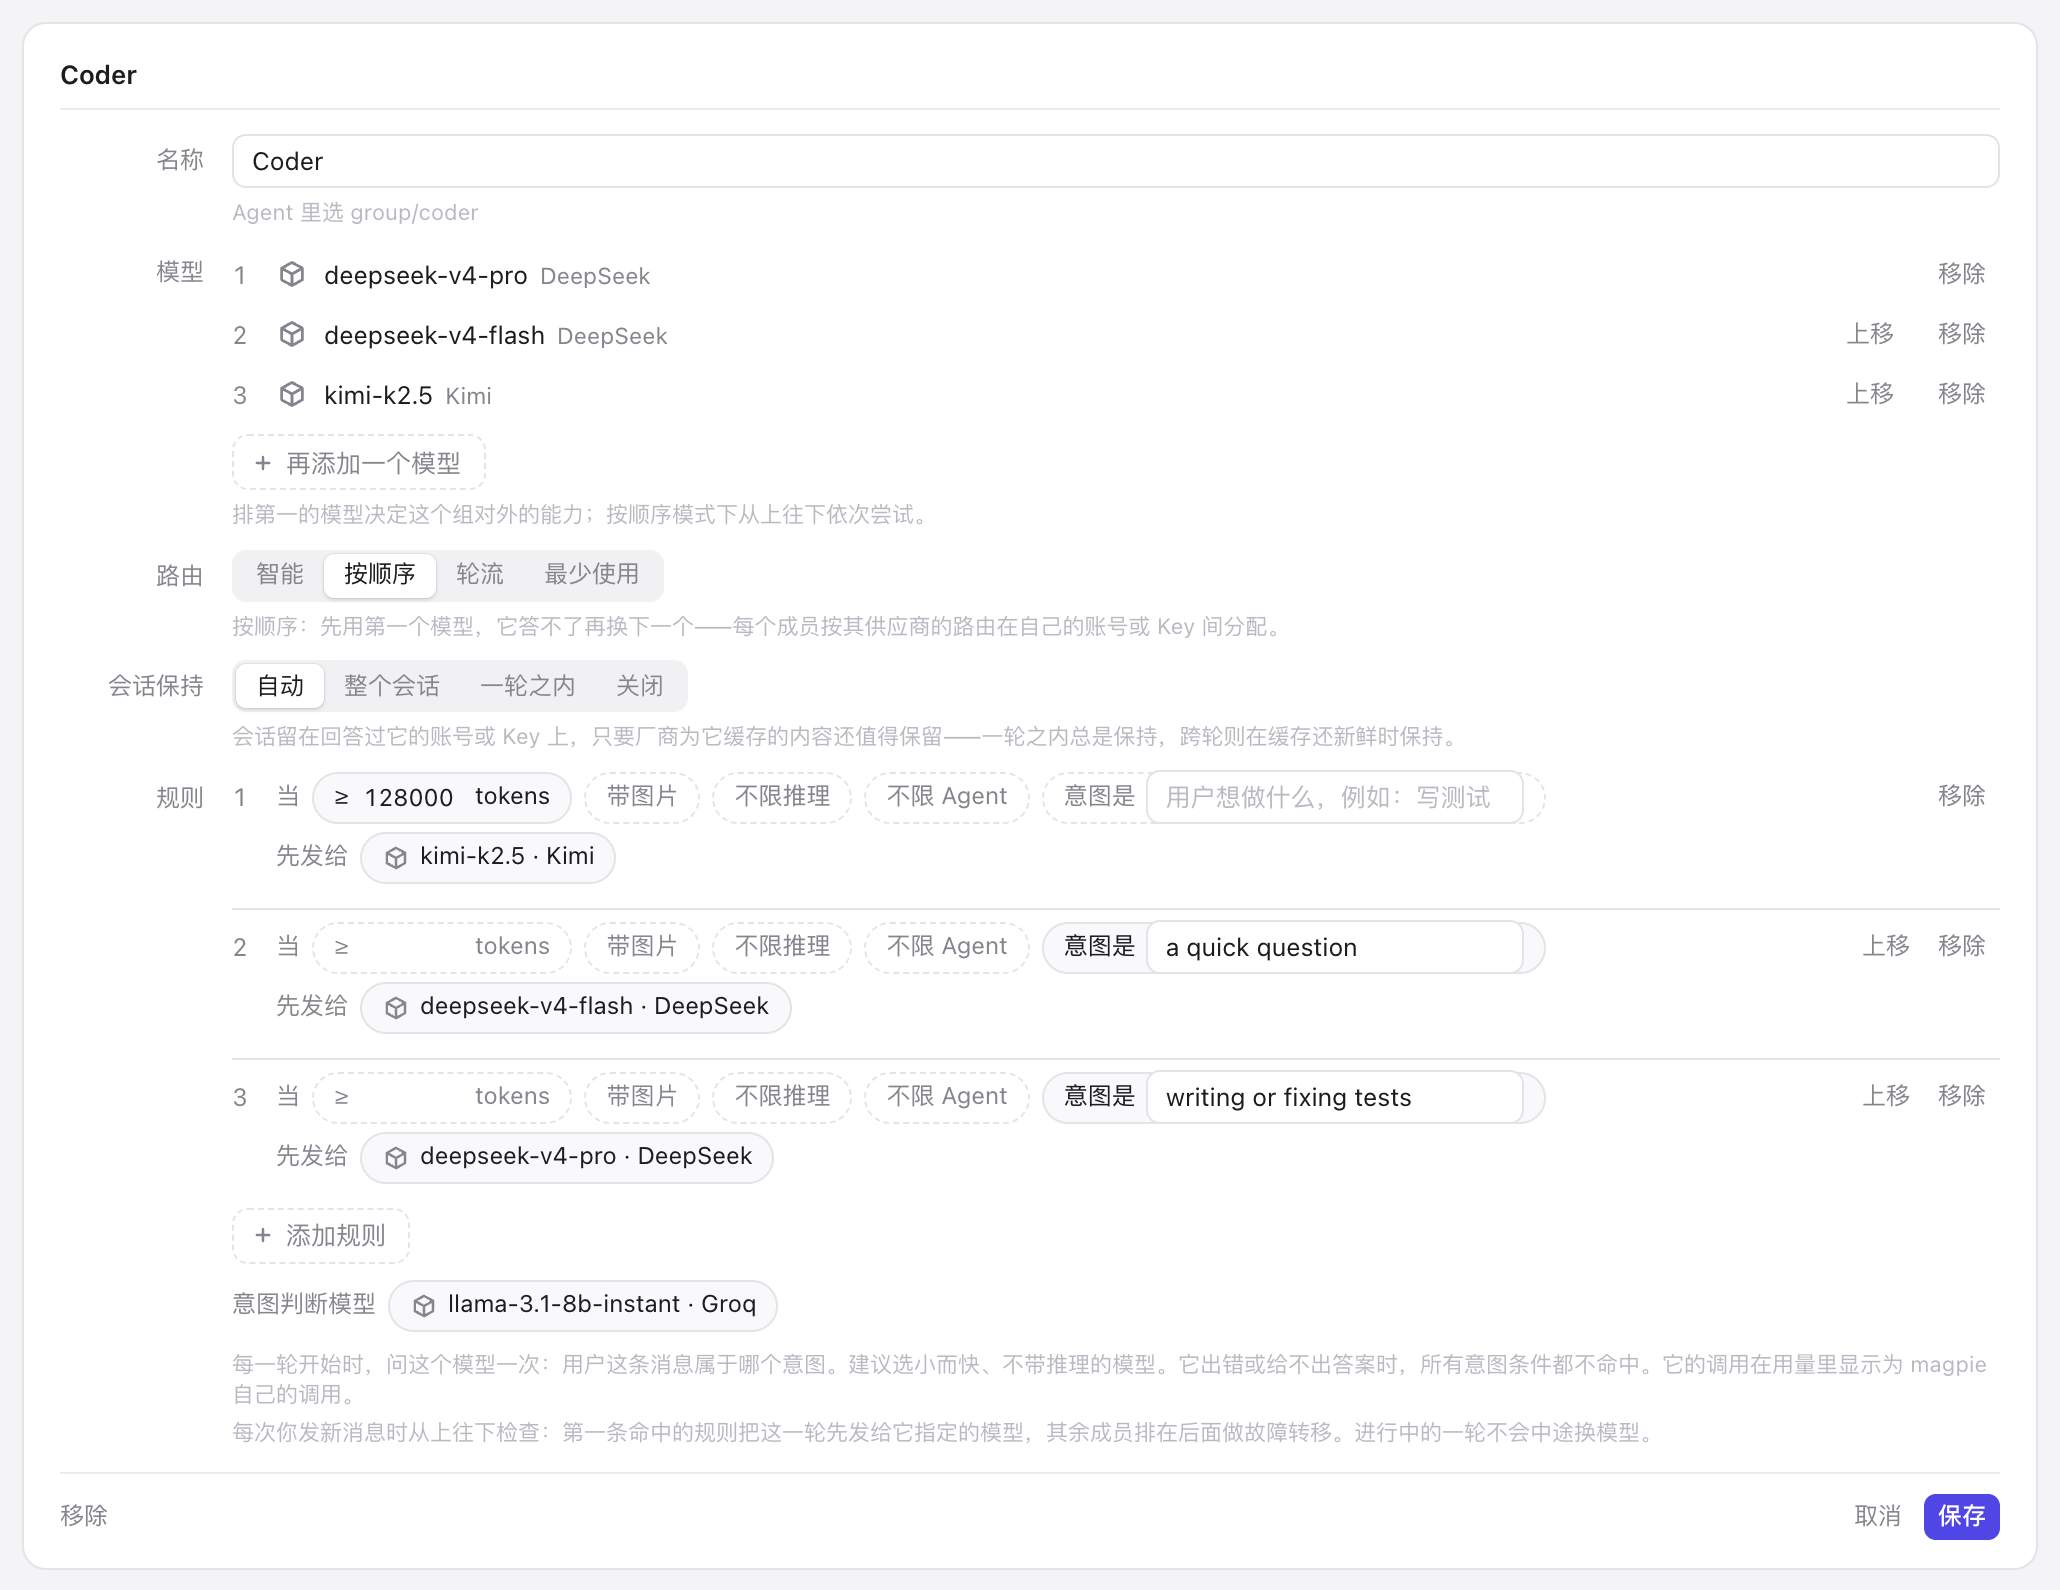
意图是路由组规则的条件之一,与长度、图片、推理、Agent 并列。本页按 v0.1.99 的实际实现,逐条说明 magpie 拿它做了什么,让你能预判每一次路由决定,并在「路由」页里核对。
设置
你需要一个至少有两个模型的路由组,再加一个用来判断意图的模型。这个模型可以是 magpie 里的任意模型,在不在组里都行。
- 打开分组进入路由页,在「路由组」里找到分组,点编辑。
- 添加带意图的规则点添加规则,在先发给里选模型,点意图是,写下这类消息想做什么,例如 writing or fixing tests 或「写测试或修测试」。同一条规则上的其他条件也必须同时满足。
- 选择意图判断模型有规则带意图后,下方会出现意图判断模型。建议选小而快、不带推理的模型。有意图却没有判断模型时,分组无法保存。
- 保存,然后发条消息从下一轮起生效,不用重启。路由页会显示判断模型说了什么、这一轮去了哪里。
命令行里也可以设置:
magpie group rule add coder use=deepseek/deepseek-v4-flash intent="a quick question" classifier=groq/llama-3.1-8b-instant
magpie group rule add coder use=deepseek/deepseek-v4-pro intent="writing or fixing tests"
magpie group rule coder                           # 带编号的规则列表和意图判断模型
magpie group rule classifier coder groq/llama-3.1-8b-instant   # 更换意图判断模型
magpie group rule mv coder 3 1                    # 顺序很重要:从上往下
magpie group rule rm coder 2
intent= 也可以写成 asks= 或 about=;classifier= 也可以写成 classify= 或 by=。在 rule add 上加 classifier= 会设置整个分组的意图判断模型,只有第一次需要。它保存在 ~/.config/magpie/providers.json 该分组的 "classifier" 字段里,每条规则保存为 {"use": …, "intent": …}。
一轮是怎么路由的
Agent 发往带规则的分组的每个请求,都按下面的顺序处理:
- 是不是新的一轮?magpie 看请求里最后一条用户消息:带文字或图片、不带工具结果,说明是你刚刚发言,新的一轮开始;带工具结果,说明是 Agent 在继续进行中的一轮(见这一轮的后续请求)。轮次按会话分别计数。子 Agent 是单独的会话:它和主 Agent 共用一个 session,但第一句话不同。
- 哪些意图可能起作用?magpie 从上往下看规则,先不管意图:一条规则的其他条件(tokens、图片、推理、Agent)对这个请求都成立,它就是候选,把它的意图收集起来。只有大小写不同的意图算同一个。遇到第一条不带意图的候选规则就停止,因为它会直接命中,排在它下面的规则都轮不到。一个意图也没收集到时,不会询问意图判断模型,也不会产生费用。
- 询问意图判断模型把收集到的意图和你这条消息的文字发给它,完整提示词见下文。这个调用和 Agent 的请求一样,走 magpie 自己的网关,所以用的是该模型所属供应商的 Key 或账号,以及它们的故障转移。它有 8 秒时间作答。
- 读取回答取回答里出现的第一个整数:
1到n表示对应的意图,0表示都不是。其他情况(没有数字、数字超出范围)这一轮都不命中意图。同一条消息、同一组意图的回答会缓存 10 分钟。 - 匹配规则带着这个回答从上往下检查规则。带意图的规则,只有判断模型说的正是它的意图(不区分大小写),并且其他条件也都满足时才命中。第一条命中的规则生效;一条都不命中时,分组按平常的方式路由这一轮。
- 给模型排序命中规则指定的模型排第一,组里其他模型按平常的顺序排在后面做故障转移。即使上一轮是别的模型回答的,也是这样:新一轮开始时,规则优先于会话保持。如果规则指定的模型此刻没有可用的 Key 或账号(都在冷却、供应商已关闭),就按分组原本的顺序,路由记录里会写明原因。
- 记住这次决定magpie 把这次决定和判断模型的回答记在这个会话名下(由分组、Agent 的 session 和会话的第一句话确定),这一轮后面的请求都照它走。
举个例子
上图的 Coder 分组有三条规则:
| # | 条件 | 先发给 |
|---|---|---|
| 1 | ≥ 128000 tokens | kimi/kimi-k2.5 |
| 2 | 意图是“a quick question” | deepseek/deepseek-v4-flash |
| 3 | 意图是“writing or fixing tests” | deepseek/deepseek-v4-pro |
- 2 万 tokens 的一轮:规则 1 不成立,两个意图都是候选,判断模型在“a quick question”和“writing or fixing tests”之间选。
- 15 万 tokens 的一轮:规则 1 不带意图且成立,收集到这里就停止。不询问判断模型,这一轮直接发给 Kimi。
- 判断模型回答
0(都不是):没有规则命中,按分组的路由方式走(这里是「按顺序」,deepseek-v4-pro 排第一)。
在界面里看
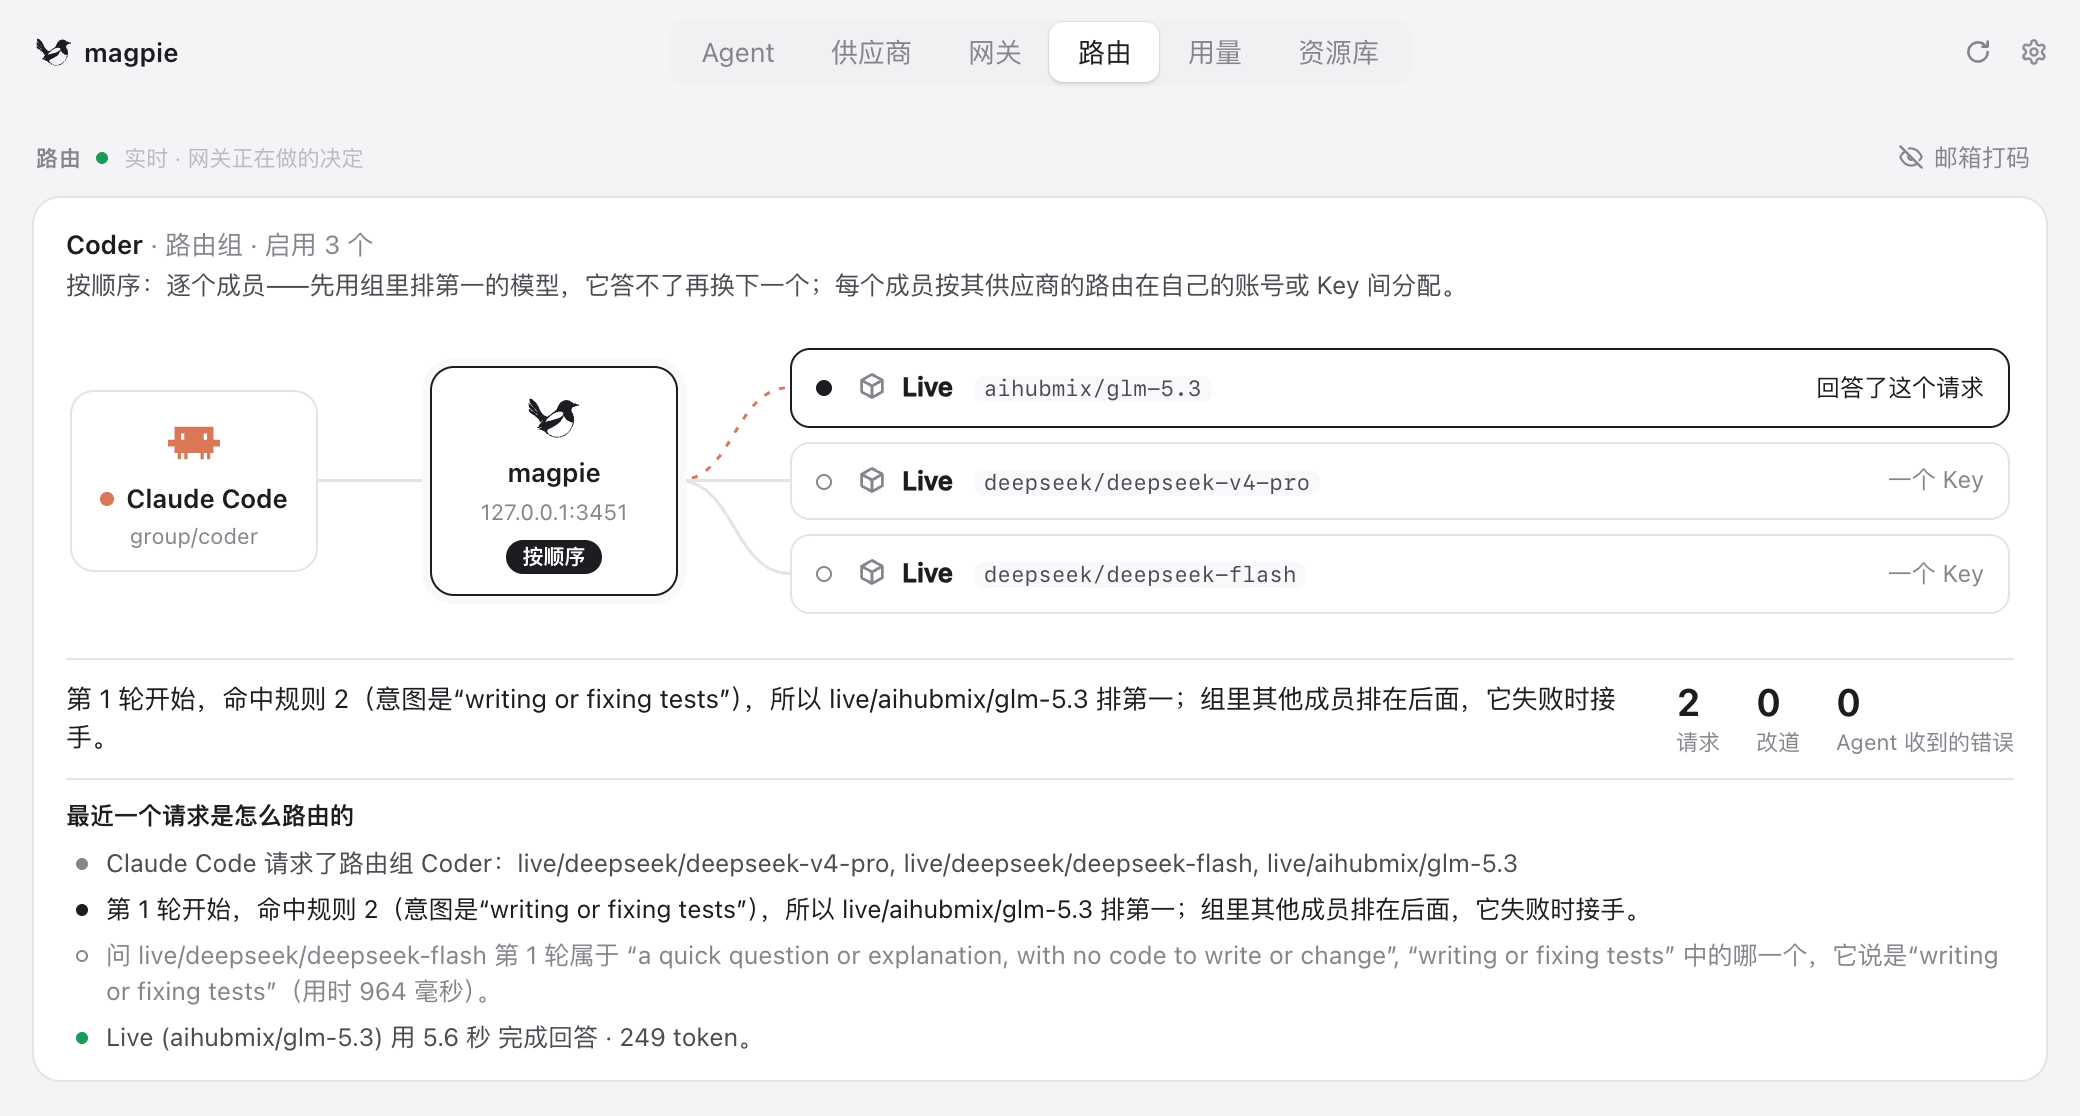
一个真实请求:分组里有两条带意图的规则(“a quick question or explanation, with no code to write or change”和“writing or fixing tests”),从 Claude Code 发出一条消息,要它给 cache.go 里的 LRU 缓存加单元测试,覆盖淘汰和并发读写。路由页实时显示它的去向。
意图判断模型看到什么
下面就是完整的请求,此外不发送任何内容。系统消息是固定的;用户消息按第 2 步收集的顺序(也就是规则顺序)列出你的意图:
You route a user's message to a coding assistant by what it asks for. Given numbered kinds of request and the user's message, answer with the number of the kind the message is, or 0 if it is none of them. Answer with the number only.
Kinds:
1. a quick question
2. writing or fixing tests

The user's message:
<message>
Write unit tests for the parseTokens function and fix any that fail.
</message>

The number of its kind (0 for none):
- 只发你最新的一条消息。magpie 只发送最后一条用户消息里的文字部分:不含之前的轮次、系统提示词、工具定义或文件。
- 不发送图片。只有图片的消息没有文字可判断,所有意图都不命中。想按图片路由,请用规则的带图片条件。
- 去掉 Agent 插入的提醒。Claude Code 附加在消息里的
<system-reminder>…</system-reminder>会被去掉;Agent 放在同一条消息里的其他文字会保留。 - 长消息会截短。超过 4000 个字符时,保留前 3000 个和后 1000 个,中间用
…连接。请求想做什么,一般在开头和结尾都能看出来。 - 请求参数。OpenAI 格式的 chat completion,不流式,
temperature 0,max_tokens 2048,User-Agent 为magpie-router/1。magpie 知道判断模型支持哪些推理档位时,会要最低的一档:支持none就用none,否则用它最低的档位(比如low);不知道档位时不传,由厂商默认。magpie 会像处理其他请求一样把它转换成判断模型所属供应商的协议,所以 Anthropic、Gemini 等模型也能用。
判断不出来时
意图判断模型只是辅助,不是关卡。它出什么问题,这一轮都照常有回答,只是带意图的规则不命中。
| 情况 | magpie 的处理 |
|---|---|
回答 0 | 所有意图都不命中,由不带意图的规则和分组平常的顺序决定 |
| 8 秒内没有回答 | 算失败:意图都不命中,这一轮立即继续 |
| 报错(额度用完、5xx、Key 无效) | 先在 8 秒内尝试它所属供应商自己的故障转移,仍然失败则意图都不命中 |
| 回答不是 0 到 n 之间的数字 | 这一轮意图都不命中。判断模型确实回答了,所以不冷却,下一轮照常询问 |
| 报错或 8 秒超时 | 这个判断模型会冷却 30 秒:这段时间里的轮次不再等它,路由记录里会写 “not asked again for now”。之后第一次答对就解除 |
| 消息里没有文字 | 不询问,意图都不命中 |
每种情况都会连同原因写进这一轮的路由记录。所以带意图的规则可能让这一轮去了你没想到的模型,但不会让它失败。
这一轮的后续请求
一轮往往包含几十个请求:Agent 调用工具,把结果发回来,再调用下一个工具……magpie 对它们的处理如下:
- 保持。这一轮里的请求都发给这一轮开始时选定的模型,不再询问意图判断模型。中途换模型会丢掉厂商为这段会话做的缓存(prompt caching),有些厂商还会拒绝别家模型写的推理内容。
- 故障转移后留在接手的模型上。规则指定的模型失败、由组里另一个成员接手后,这一轮剩下的请求都交给接手的成员(会话保持为「自动」「整个会话」或「一轮之内」时)。等你下次发言,规则再重新决定。
- 超出上下文。唯一的例外:这一轮进行中,会话涨到当前模型上下文的 95% 时,magpie 会沿用之前的判断结果重新检查一遍规则。如果有规则把它发往上下文更大的模型,就换过去;不会换到上下文更小的模型。
- 等待下一轮。如果 magpie 没看到这一轮开始(magpie 是在某一轮进行中启动或重启的),或者当初决定这一轮的规则被删除、或改成了发往别的模型,那么不会有规则移动这一轮,等你下次发言时再重新决定。
- 子 Agent。子 Agent 的轮次单独决定,依据它自己的消息。规则可以把子 Agent 发往别处,而主 Agent 留在原来的模型上。
这些决定保存在内存里,保留到会话最后一个请求之后 24 小时。重启 magpie 会清空它们,下一条消息会重新决定。
看懂路由记录
路由页会显示每个分组最近的一个请求由谁回答;最近一个请求是怎么路由的下面写着原因。
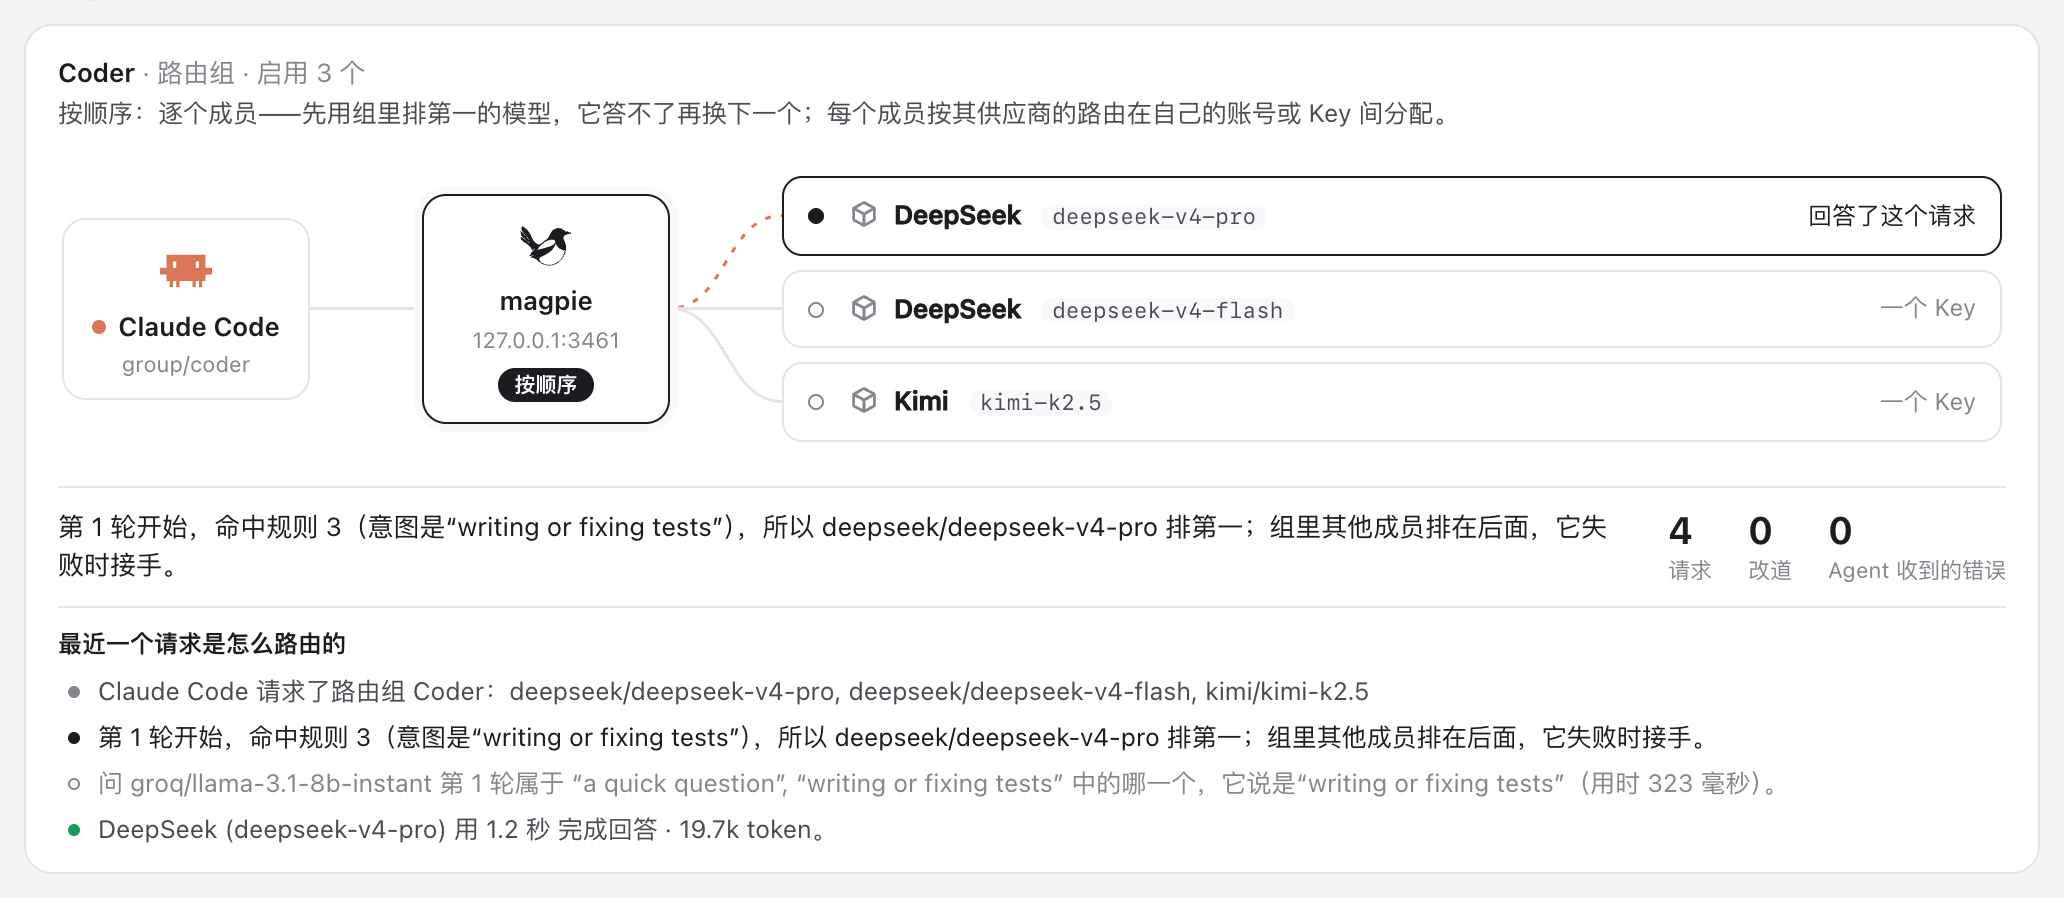
与意图相关的几种记录:
| 记录里写的 | 含义 |
|---|---|
| 问 … 第 1 轮属于 “A”, “B” 中的哪一个,它说是“B”(用时 323 毫秒)。 | 询问了判断模型,候选是这几个,它选了 B |
| … 它说都不是(…)。 | 它回答了 0 |
| …(同一条消息之前已判断过)。 | 回答来自 10 分钟缓存,这次没有发出调用 |
| … 本应判断 … 但没能给出答案(原因),所以带意图的规则都不命中。 | 判断失败;原因是报错、超时、它的原始回答,或者它还在失败后的冷却期 |
| 第 N 轮开始,命中规则 R(意图是“B”),所以 M 排第一 … | 生效的规则,以及被排到第一的模型 |
| 命中规则 R,但 M 现在没有可用的账号或 Key,所以按分组原本的顺序。 | 规则指定的模型此刻没有可用的 Key 或账号 |
| 第 N 轮开始时命中规则 R(…),发给了 M;这一轮一直留在那里。 | 这一轮里的工具往返请求,沿用开始时的决定 |
| 这一轮在 magpie 看到之前就已开始,规则等下一轮再判断。 | 见上文「等待下一轮」 |
意图判断模型自己的调用,在用量页里记在 Agent magpie 名下,带 token 数和费用,判断意图花了多少一看便知。
延迟、费用、隐私
- 延迟。只有每一轮的第一个请求需要等判断模型,在快的供应商上通常是几百毫秒(截图里是 323 毫秒),最长 8 秒。这一轮后面的工具往返、没有意图需要判断的轮次、命中缓存的回答,都不增加延迟。
- 费用。每轮一次很短的调用:输入大约是你的消息加上意图列表,输出一两个 token。上面的例子是输入 212、输出 1。用订阅里的模型做判断模型时,这些调用会占用该订阅的额度。
- 隐私。你这条消息的文字(最多约 4000 个字符)会发给判断模型所属的供应商。想让它不离开本机,可以用 Ollama 或 LM Studio 里的本地模型来判断。magpie 只在内存里保存消息的哈希值和判断结果,保留 10 分钟;消息原文不存储,也不写日志。
怎么写意图
- 描述请求本身,而不是模型。写「写测试或修测试」,不要写「交给 Opus 的难题」。判断模型只看得到你写的这几个词和那条消息。
- 类别之间要分得开。两个意图有重叠(「提问」和「关于代码的提问」)时,小模型会在两者之间随机摇摆。要么合并,要么把区别写清楚。
- 少而宽,胜过多而窄。2 到 5 个意图对 8B 级别的模型很轻松。每个意图最多 200 个字符,但通常几个词就够了。
- 顺序依然重要。只有第一条命中的规则生效,所以必须优先的规则(例如长上下文规则)要放在带意图的规则上面。它成立时,连判断模型都不用问。
- “都不是”也是有效回答。不属于任何意图的轮次按分组平常的顺序走,所以把你的默认模型放在这个顺序的第一位。
- 中文英文都行。意图和消息可以用判断模型能理解的任何语言书写。固定的提示词是英文的,小模型处理中英混合没有问题。
- 怎么选判断模型。选小而快、不带推理的模型:Groq 上的 Llama 3.1 8B、各家的 Flash-Lite / nano / mini 系列、Claude Haiku、DeepSeek 的非推理对话模型,或者本地模型。推理模型更慢;magpie 会要它最低的推理档位并留 2048 个 token,但慢的模型仍可能超过 8 秒。先观察几轮路由记录,判断不准时,先改意图的措辞,再考虑换模型。
数值一览
| 项目 | 数值 |
|---|---|
| 判断超时 | 8 秒,包含其供应商的故障转移 |
| 失败后冷却 | 30 秒,按判断模型计 |
| 回答缓存 | 10 分钟,按判断模型 + 意图 + 消息;仅内存 |
| 轮次决定保留 | 会话最后一个请求之后 24 小时;仅内存 |
| 发送的消息长度 | 最多 4000 字符;更长时取前 3000 + 后 1000 |
| 判断请求参数 | temperature 0,max_tokens 2048,模型最低的推理档位,不流式 |
| 意图长度 | 最多 200 字符;多余空白会合并,比较时不区分大小写 |
| 超出上下文 | 达到当前模型上下文的 95% 时,只换到上下文更大的模型 |
答疑
这是向量嵌入 / 语义检索吗?
不是。没有嵌入模型,没有相似度阈值,没有关键词表,也不需要训练。判断模型就是一个普通的对话模型:读你的意图和消息,回答一个编号。效果取决于这个模型和你的措辞,每一次的回答都能在路由记录里看到。
它会看整段对话吗?
不会,只看你刚发的那一条。所以像「另一个文件也照这样改」这样的追问,只按这几个字判断。要么把这一轮的消息写清楚一些,要么加一个适合追问的意图。
我发一条消息,Agent 发了 40 个请求,判断模型被问了 40 次吗?
不是,只问一次。另外 39 个请求带的是工具结果,属于同一轮,沿用这一轮的决定。路由记录(「这一轮一直留在那里」)和用量页(只有一次 magpie 调用)都能看到这一点。
一轮进行到一半会换模型吗?
只有两种情况:当前模型失败、由组里另一个成员接手;或者会话超出当前模型的上下文,有规则把它发往上下文更大的模型。一轮之中不会重新判断意图。
判断模型挂了或者很慢怎么办?
这一轮照常进行。最多等 8 秒后,意图都不命中,由分组的其他规则和顺序决定。接下来 30 秒内 magpie 不再询问这个判断模型,免得每一轮都要等满超时。路由记录里会写明原因。
判断模型说的就是这条规则的意图,为什么没有发给规则指定的模型?
看路由记录。常见原因有:
- 上面有别的规则先命中了;
- 这条规则的其他条件不满足(tokens、图片、推理、Agent);
- 规则指定的模型此刻没有可用的 Key 或账号(「现在没有可用的账号或 Key」);
- 这是一轮里的工具往返请求,而这一轮开始时去的是别的模型;
- magpie 没看到这一轮开始(「规则等下一轮再判断」)。
两条规则写了同一个意图会怎样?
这个意图只给判断模型看一次。选中它时,这几条规则里其他条件也满足的第一条生效。可以借此把 Codex 发来的「写测试」交给一个模型,把 Claude Code 发来的交给另一个。
改了规则,会影响正在进行的一轮吗?
不会。保存后从下一轮开始生效。如果决定当前这一轮的规则被删除了,或者改成发往别的模型,这一轮会留在原处直到结束,路由记录里写着规则等下一轮再判断。
判断模型可以是一个路由组吗?可以是组里的成员吗?
不能是路由组:它必须是单个模型(provider/model),保存时 magpie 会校验。它可以是 magpie 里的任何模型,包括组里的成员、订阅里的模型或本地模型。
可以用推理模型吗?
可以,只要它能在 8 秒内回答。magpie 会要它最低的推理档位(有 none 用 none,否则用最低一档),并留 2048 个 token,思考不会挤掉答案。不过小而快的模型仍是更好的选择:更便宜,而且每一轮都要等它。
重试同一条消息,会再问一次吗?
10 分钟内不会:同一条消息、同一组意图、同一个判断模型,直接用缓存的回答,路由记录里写「同一条消息之前已判断过」。改了意图或者换了判断模型,就会重新询问。
支持哪些 Agent?
凡是通过 magpie 使用路由组的 Agent 都支持:Claude Code、Codex、OpenCode、Gemini CLI 等。轮次是从请求本身识别的(带文字、不带工具结果的消息),和 Agent 用哪种 API 无关。
我的消息会被存下来吗?
magpie 只在内存里保存它的哈希值(用于缓存)和判断结果。原文会像其他请求一样发给判断模型所属的供应商,适用该供应商的条款。判断调用的用量记录里只有 token 数,没有原文。
准确率怎么样?
取决于判断模型,也取决于你的意图之间区分得是否清楚。几个明显不同的类别,小模型能判断得很好;有重叠的类别,它有时会猜错。判断错或没判断出来,影响的只是由哪个模型回答,所以建议先写两三个宽泛的意图,看一天路由记录,再调整措辞。
用真实模型测过吗?
测过。我们把 20 条真实的编程消息(中英文都有:简单提问、写测试/修测试、普通编码任务,还有 “Fix the bug in parseTokens and add a test for it” 这种混合的)发给一个带两条意图规则的分组。DeepSeek V4 Flash、GLM-5.3 Flash、MiMo v2.6 Flash 作为判断模型都是 20/20 全对,判断耗时中位数分别是 0.75 秒、1.3 秒、1.9 秒。某家中转上的 Gemini 3.8 Flash 即使用 low 推理档位也要 11 秒,每一轮都超时,于是都按没有意图规则的方式路由,路由记录每次都写明了原因。这也说明:判断模型选得不好,损失的只是路由效果,不会让这一轮失败。